


समय - सीमा 288
मानव और उनकी इंद्रियाँ 1077
मानव और उनके आविष्कार 837
भूगोल 281
जीव-जंतु 327
समय - सीमा 288
मानव और उनकी इंद्रियाँ 1077
मानव और उनके आविष्कार 837
भूगोल 281
जीव-जंतु 327
जब हम तकनीक की बात करते हैं, तो एनकोडिंग एक ऐसा शब्द है जो डेटा स्टोरेज, संचार, प्रोग्रामिंग और मल्टीमीडिया में बार-बार सामने आता है। लेकिन जब आप अपने कीबोर्ड पर कोई अक्षर टाइप करते हैं, तो कंप्यूटर उस अक्षर को सीधे तौर पर नहीं देखता है; वह केवल एक बाइनरी संख्या को समझता है। उस अक्षर को संख्यात्मक रूप में बदलने की प्रक्रिया ही एनकोडिंग कहलाती है। आधुनिक कंप्यूटरों से लेकर स्मार्टफोन तक, हर उपकरण इसी तकनीक पर निर्भर करता है।
कंप्यूटर की दुनिया में एनकोडिंग क्या है और यह क्यों जरूरी है?
एनकोडिंग (Encoding) सूचना को एक रूप या प्रारूप से दूसरे रूप में परिवर्तित करने की प्रक्रिया है। आमतौर पर, यह परिवर्तन इसलिए किया जाता है ताकि डेटा को कंप्यूटर और अन्य उपकरणों द्वारा कुशलतापूर्वक संग्रहीत, प्रेषित या संसाधित किया जा सके। इसे एक ऐसे संदेश के अनुवाद के रूप में समझा जा सकता है जिसे प्राप्तकर्ता या सिस्टम सबसे अच्छी तरह समझता है। एनकोडिंग के कई फायदे हैं।
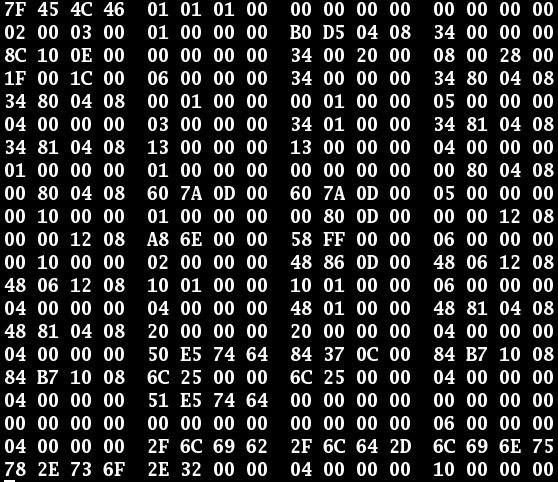
सबसे पहले, यह डेटा स्टोरेज में मदद करता है। कंप्यूटर डेटा को बाइनरी में संख्याओं के रूप में संग्रहीत करते हैं। एनकोडिंग टेक्स्ट, इमेज और साउंड जैसे विभिन्न प्रकार के डेटा को बाइनरी में दर्शाने की अनुमति देता है। दूसरा, यह डेटा ट्रांसमिशन के लिए महत्वपूर्ण है। चाहे इंटरनेट पर संदेश भेजना हो या वीडियो स्ट्रीम करना हो, एनकोडिंग डेटा को पैकेज करने में मदद करता है ताकि यह सटीक रूप से यात्रा कर सके। तीसरा, यह अनुकूलता सुनिश्चित करता है, जिससे एक सिस्टम पर बनाया गया डेटा दूसरे सिस्टम पर सही ढंग से पढ़ा जा सके। इसके अलावा, डेटा सुरक्षा के लिए भी एनकोडिंग की भूमिका अहम है।
एनकोडिंग के प्रमुख प्रकार कौन-कौन से हैं?
डेटा के प्रकार और उसके उपयोग के आधार पर एनकोडिंग कई रूप ले लेती है। कैरेक्टर एनकोडिंग (Character Encoding) अक्षरों, संख्याओं और प्रतीकों को बाइनरी में बदलने के बारे में है ताकि कंप्यूटर टेक्स्ट को समझ और प्रदर्शित कर सके। इसके उदाहरण आस्की, यूटीएफ-8 (UTF-8) और यूनिकोड हैं। यूटीएफ-8 आज दुनिया भर की अधिकांश भाषाओं के लिए एक लोकप्रिय एनकोडिंग है, जो कई अक्षरों और इमोजी का समर्थन करता है।
मल्टीमीडिया फाइलों को छोटा करने के लिए ऑडियो और वीडियो एनकोडिंग का उपयोग होता है, जिसमें एमपी3 (MP3) और एएसी (AAC) ऑडियो को कंप्रेस करते हैं, जबकि एच.264 (H.264) और एच.265 (H.265) वीडियो को कंप्रेस करते हैं। संचार के लिए डेटा एनकोडिंग में बेस64 (Base64) बाइनरी डेटा को टेक्स्ट प्रारूप में बदलता है ताकि इसे ईमेल के माध्यम से भेजा जा सके। इसी तरह यूआरएल एनकोडिंग वेबसाइट पतों में विशेष वर्णों को ऐसे प्रारूप में परिवर्तित करता है जिसे ब्राउज़र सुरक्षित रूप से संभाल सकें। प्रोग्रामिंग भाषाओं में जैसे कोटलिन (Kotlin), स्ट्रिंग एनकोडिंग और डिकोडिंग को आसानी से संभाला जा सकता है।
आस्की कोड की शुरुआत कब और कैसे हुई थी?
आस्की (ASCII) का पूरा नाम अमेरिकन स्टैंडर्ड कोड फॉर इंफॉर्मेशन इंटरचेंज है। 1963 में अमेरिकन नेशनल स्टैंडर्ड इंस्टीट्यूट द्वारा आस्की मानक प्रख्यापित किया गया था, जो कंप्यूटर में अक्षरों, संख्याओं, विराम चिह्नों और नियंत्रण संकेतों का प्रतिनिधित्व करने के लिए सात बिट्स के पैटर्न को निर्दिष्ट करता है। ऐतिहासिक रूप से, आस्की टेलीग्राफिक कोड से विकसित हुआ। इसका पहला व्यावसायिक उपयोग बेल डेटा सेवाओं द्वारा प्रचारित सात-बिट टेलीप्रिंटर कोड के रूप में किया गया था।
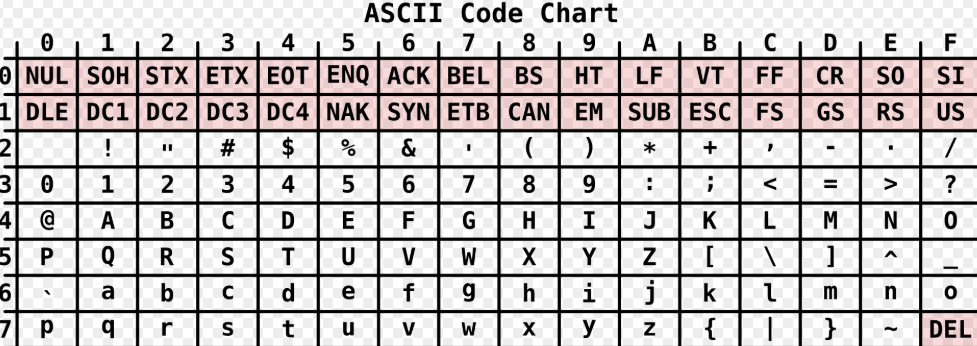
आस्की पर औपचारिक काम 6 अक्टूबर 1960 को अमेरिकन स्टैंडर्ड एसोसिएशन की X3.2 उपसमिति की पहली बैठक के साथ शुरू हुआ। मानक का पहला संस्करण 1963 में प्रकाशित हुआ था। आस्की में 128 वर्णों की परिभाषाएं शामिल हैं, जिनमें 33 गैर-मुद्रण नियंत्रण वर्ण हैं, 94 मुद्रण योग्य वर्ण हैं, और स्पेस को एक अदृश्य ग्राफिक माना जाता है। 2008 तक वर्ल्ड वाइड वेब पर सबसे अधिक उपयोग किया जाने वाला कैरेक्टर एनकोडिंग आस्की ही था, जिसके बाद यूटीएफ-8 ने इसकी जगह ले ली।
यूनिकोड कंसोर्टियम ने वैश्विक भाषाओं को डिजिटल पहचान कैसे दी?
यूनिकोड कंसोर्टियम को जनवरी 1991 में कैलिफोर्निया राज्य में शामिल किया गया था। इसकी शुरुआत 1987 में ज़ेरॉक्स (Xerox) के इंजीनियर जो बेकर (Joe Becker) और एप्पल (Apple) के इंजीनियरों ली कॉलिन्स (Lee Collins) और मार्क डेविस (Mark Davis) द्वारा की गई चर्चाओं के बाद हुई। इनका लक्ष्य एक नया कैरेक्टर एनकोडिंग बनाना था, जिसे यूनिकोड (Unicode) कहा गया।
प्रारंभिक यूनिकोड मानक 1991 में प्रकाशित हुआ था। इसका लक्ष्य आधुनिक पाठ में सभी वर्णों का प्रतिनिधित्व करने के लिए एक चर बिट मानक बनाना था, जिसमें सभी लैटिन, एशियाई, ग्रीक, अरबी, सिरिलिक और हिब्रू वर्णमाला, संगीत, अंतर्राष्ट्रीय ध्वन्यात्मक वर्णमाला, इमोजी और यहां तक कि ब्रेल भी शामिल थे। आधुनिक कंप्यूटर और मोबाइल उपकरणों पर लगभग सभी वर्णों का आधार अब यूनिकोड मानक ही है।
डिजिटल ब्रेल लिपि और स्क्रीन रीडर तकनीक कैसे काम करती है?
कंप्यूटर और मोबाइल उपकरणों पर ब्रेल डिस्प्ले का उपयोग करते समय, स्क्रीन रीडर ही यह निर्धारित करता है कि कौन से ब्रेल कोड उपलब्ध होंगे। यूनिकोड मानक के कारण, सभी 256 आठ-डॉट ब्रेल वर्णों का यूनिकोड मान U+2800 से U+28ff तक होता है। स्क्रीन रीडर इन वर्णों को ब्रेल में प्रस्तुत करने के लिए जिम्मेदार है। यह एक सुचारू प्रक्रिया है, लेकिन कभी-कभी इसमें तकनीकी समस्याएं भी आती हैं।
उदाहरण के लिए, एपोस्ट्रोफी (Apostrophe) वर्ण को लेकर समस्या आती है। यूनिकोड में, अक्सर एपोस्ट्रोफी और एकल क्लोजिंग कोटेशन मार्क दोनों को दर्शाने के लिए एक ही वर्ण का उपयोग किया जाता है। आम पाठकों को यह अंतर दिखाई नहीं देता, लेकिन ब्रेल पाठकों के लिए यह एक समस्या है क्योंकि ब्रेल में एपोस्ट्रोफी और क्लोजिंग कोट पूरी तरह से अलग होते हैं। कई ब्रेल पाठक कॉन्ट्रैक्टेड ब्रेल पढ़ना पसंद करते हैं, जिसके लिए स्क्रीन रीडर एक ब्रेल तालिका तक पहुंचता है जो यह जानकारी प्रदान करती है कि पाठ को कैसे अनुबंधित किया जाना चाहिए।
मोबाइल और कंप्यूटर ऑपरेटिंग सिस्टम में ब्रेल कोड के क्या विकल्प मौजूद हैं?
एप्पल के आईओएस (iOS) और आईपैडओएस (iPadOS) उपकरणों में वॉयसओवर (VoiceOver) सुविधा के तहत ब्रेल सेटिंग्स मौजूद होती हैं। इसमें आउटपुट और इनपुट के लिए अनकॉन्ट्रैक्टेड 6-डॉट, अनकॉन्ट्रैक्टेड 8-डॉट और कॉन्ट्रैक्टेड ब्रेल के विकल्प मिलते हैं। अनकॉन्ट्रैक्टेड 6-डॉट ब्रेल में बड़े अक्षरों को इंगित करने के लिए डॉट 6 का उपयोग होता है, जबकि 8-डॉट ब्रेल में डॉट 7 का उपयोग किया जाता है। अमेरिका में डिफ़ॉल्ट रूप से इंग्लिश यूनिफाइड (Unified English Braille) टेबल लोड होती है। मैक (Mac) कंप्यूटरों में भी वॉयसओवर यूटिलिटी के तहत इसी तरह की सेटिंग्स और ब्रेल ट्रांसलेशन टेबल्स उपलब्ध होती हैं।
एंड्रॉइड (Android) उपकरणों की बात करें तो अगस्त 2022 में एंड्रॉइड 13.0 के जारी होने के साथ ब्रेल सुविधाओं को गूगल के स्क्रीन रीडर टॉकबैक (TalkBack) में एकीकृत किया गया था। जनवरी 2023 में, गूगल ने टॉकबैक 13.1 जारी किया जिसमें ब्रेल तालिकाओं की एक विस्तृत सूची उपलब्ध कराई गई। इसमें 6-डॉट कंप्यूटर ब्रेल और नॉर्थ अमेरिकन ब्रेल कंप्यूटर कोड जैसे विकल्प जोड़े गए, जिससे बीआरएफ (BRF) फाइलें पढ़ना संभव हो सका।
विंडोज़ (Windows) पीसी पर सबसे लोकप्रिय स्क्रीन रीडर जॉज़ (JAWS) और एनवीडीए (NVDA) हैं। जॉज़ में दर्जनों भाषाओं के लिए ब्रेल अनुवाद की सुविधा है, जिसमें कंप्यूटर ब्रेल, यूएस इंग्लिश ग्रेड 1 और ग्रेड 2, और यूनिफाइड इंग्लिश ब्रेल के विकल्प मिलते हैं। जॉज़ में 8-डॉट ब्रेल मोड में टेक्स्ट प्रदर्शित करने का विकल्प भी है। एनवीडीए में भी 6-डॉट और 8-डॉट कंप्यूटर ब्रेल के साथ-साथ ग्रेड 1 और ग्रेड 2 के इनपुट और आउटपुट टेबल उपलब्ध हैं। इन सभी तकनीकी प्रगति ने दृष्टिबाधित लोगों के लिए डिजिटल दुनिया को बहुत अधिक सुलभ और समावेशी बना दिया है।
संदर्भ
1. https://tinyurl.com/27w69ypr
2. https://tinyurl.com/2agpuvfc
3. https://tinyurl.com/2augl5st
4. https://tinyurl.com/22d972fr
A. City Readerships (FB + App) - This is the total number of city-based unique readers who reached this specific post from the Prarang Hindi FB page and the Prarang App.
B. Website (Google + Direct) - This is the Total viewership of readers who reached this post directly through their browsers and via Google search.
C. Messaging Subscribers - This is the total viewership from City Portal subscribers who opted for hyperlocal daily messaging and received this post.
D. Total Viewership - This is the Sum of all our readers through FB+App, Website (Google+Direct), Email, WhatsApp, and Instagram who reached this Prarang post/page.
E. The Reach (Viewership) - The reach on the post is updated either on the 6th day from the day of posting or on the completion (Day 31 or 32) of one month from the day of posting.